
Vier Zahlen für eine Antwort
Füg die Antwort auf eine Frage deiner koreanischen Selbstvorstellung (자기소개서, Jagisogaeseo) in das Feld „Text“ ein, und du bekommst vier Zahlen. Nennt die Ausschreibung ein Limit in Zeichen (자), gelten die beiden großen Werte „Zeichen (mit Leerzeichen)“ und „Zeichen (ohne Leerzeichen)“. Steht dort „바이트“ oder „byte“, schau auf „Bytes (koreanische Doppelbyte-Regel)“ und „Bytes (UTF-8)“ daneben. Als Zeichen zählt, was auf dem Bildschirm wie eines aussieht. Satzzeichen und Leerzeichen sind also jeweils 1 Zeichen. Bei mehreren Fragen leerst du das Feld mit „Leeren“ und prüfst jede Antwort für sich.
Die koreanische Doppelbyte-Regel
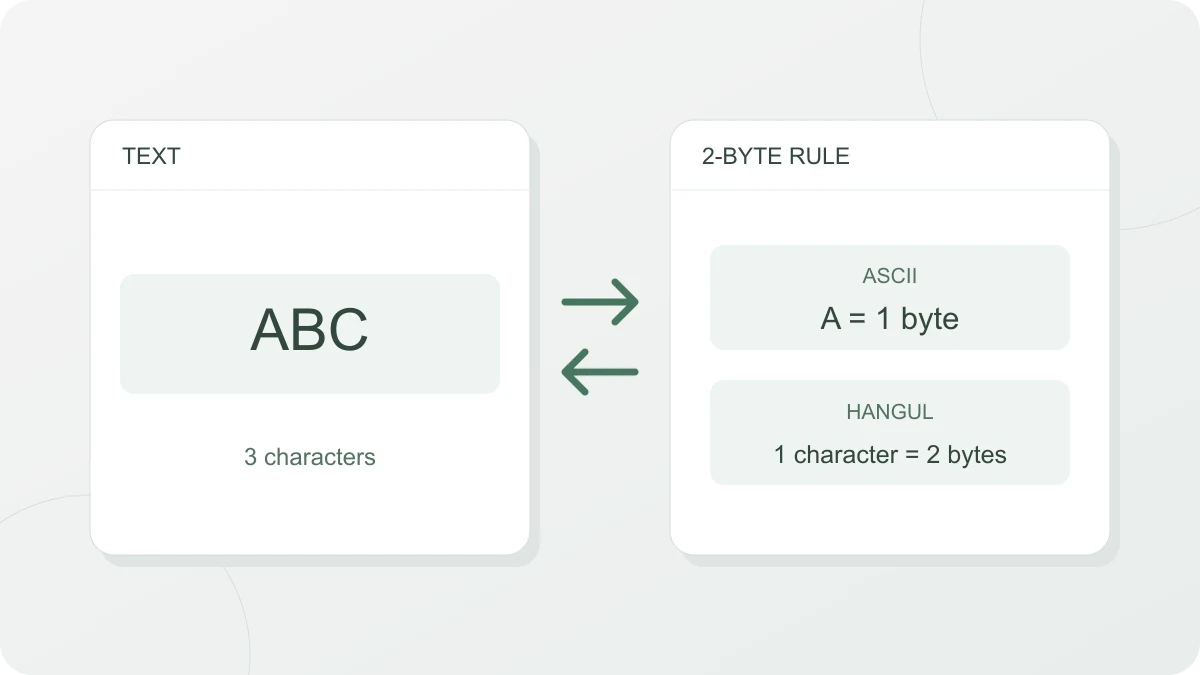
Manche koreanische Bewerbungsportale begrenzen die Antworten nicht nach Zeichen, sondern nach Bytes. ASCII-Zeichen wie lateinische Buchstaben, Ziffern, Leerzeichen und Zeilenumbrüche zählen dabei 1 Byte, alles andere 2 Bytes: Hangul, Hanja (chinesische Schriftzeichen), Sonderzeichen, Emojis. So hat die ältere koreanische Zeichenkodierung EUC-KR ihre Zeichen gespeichert.
| Zeichen | Doppelbyte-Regel | UTF-8 |
|---|---|---|
| Lateinische Buchstaben, Ziffern, ASCII-Zeichen (A, 1, !) | 1 Byte | 1 Byte |
| Leerzeichen, Zeilenumbruch | 1 Byte | 1 Byte |
| Hangul (가) | 2 Bytes | 3 Bytes |
| Hanja (字) | 2 Bytes | 3 Bytes |
| Mittelpunkt (·) | 2 Bytes | 2 Bytes |
| Emoji (😀) | 2 Bytes | 4 Bytes |
Als Formel: Bytes nach der Doppelbyte-Regel = Zahl der ASCII-Zeichen + Zahl der übrigen Zeichen × 2. Auch ein allein stehender Konsonant wie in „ㅋㅋ“, dem koreanischen „haha“ im Chat, kostet je Zeichen 2 Bytes.
Ein Satz als Rechenbeispiel
Für 저는 2024년에 IT 동아리를 만들었습니다. („Ich habe 2024 einen IT-Club gegründet.“) zeigt der Zähler:
| Wert | Ergebnis | Rechnung |
|---|---|---|
| Zeichen (mit Leerzeichen) | 25 | 14 Hangul-Zeichen + 4 Ziffern + 2 lateinische Buchstaben + 4 Leerzeichen + 1 Punkt |
| Zeichen (ohne Leerzeichen) | 21 | 25 minus 4 Leerzeichen |
| Bytes (koreanische Doppelbyte-Regel) | 39 B | 14 Hangul-Zeichen × 2 Bytes + 11 ASCII-Zeichen × 1 Byte |
| Bytes (UTF-8) | 53 B | 14 Hangul-Zeichen × 3 Bytes + 11 ASCII-Zeichen × 1 Byte |
Zeichen und Bytes umrechnen
Besteht ein Text nur aus Hangul ohne Leerzeichen, ist die Byte-Zahl das Doppelte der Zeichenzahl. 1.000 Bytes sind dann 500 Zeichen. Zählt das Portal in UTF-8, braucht ein Hangul-Zeichen 3 Bytes, und dieselben 1.000 Bytes reichen nur noch für 333 Zeichen.
In echten Sätzen stehen dazwischen Leerzeichen, Ziffern und lateinische Buchstaben zu je 1 Byte. Mit Leerzeichen gezählt passen in 1.000 Bytes deshalb mehr als 500 Zeichen. Auch der Beispielsatz oben kommt mit seinen 25 Zeichen auf 39 Bytes und nicht auf das Doppelte, also 50 Bytes. Wie viel mehr hineinpasst, hängt vom Text ab. Schätz es nicht, sondern füg den fertigen Text ein.
Wo echtes EUC-KR abweicht
Der Zähler setzt für jedes Zeichen außerhalb von ASCII 2 Bytes an. Das echte EUC-KR (KS X 1001) enthält von den 11.172 möglichen Hangul-Silben nur 2.350. Einige Silben wie „똠“ oder „햏“ kann es deshalb nicht darstellen, Emojis ebenso wenig. Der Zähler rechnet auch für sie 2 Bytes, aber was ein Portal tatsächlich damit macht, unterscheidet sich von Portal zu Portal. Die Zeichen können verstümmelt ankommen, oder die Eingabe wird abgelehnt. In einer Bewerbung verzichtest du besser auf Emojis und seltene Silben.
Auch wenn die Textverarbeitung gerade Anführungszeichen (“) automatisch durch typografische (“ ”) ersetzt, kostet das Bytes. Aus 1 Byte je Anführungszeichen werden 2: “안녕” in geraden Anführungszeichen hat 6 Bytes, “안녕” in typografischen 8 Bytes.
Wenn du ein Byte-Limit einhalten musst
- Zeilenumbrüche: Der Zähler rechnet 1 Byte je Zeilenumbruch. Zählt das Portal einen Zeilenumbruch als 2 Bytes, kommt dort je Zeilenumbruch 1 Byte dazu. Ein Text aus vier Absätzen hat 3 Zeilenumbrüche und braucht 3 Bytes Reserve, mit je einer Leerzeile zwischen den Absätzen sind es 6 Bytes.
- Wo sich kürzen lässt: Leerzeilen zwischen Absätzen und doppelte Leerzeichen kannst du streichen, ohne den Inhalt anzutasten. Ersetzt du 2-Byte-Zeichen wie den Mittelpunkt (·) oder typografische Anführungszeichen durch ein Komma oder gerade Anführungszeichen, sparst du je Zeichen 1 Byte.
- Letzte Kontrolle: Füg den Text in das Eingabefeld des Portals ein und nimm die Zahl, die dort erscheint, als maßgeblich. Weicht sie von diesem Zähler ab, prüf zuerst, wie das Portal Zeilenumbrüche zählt.