
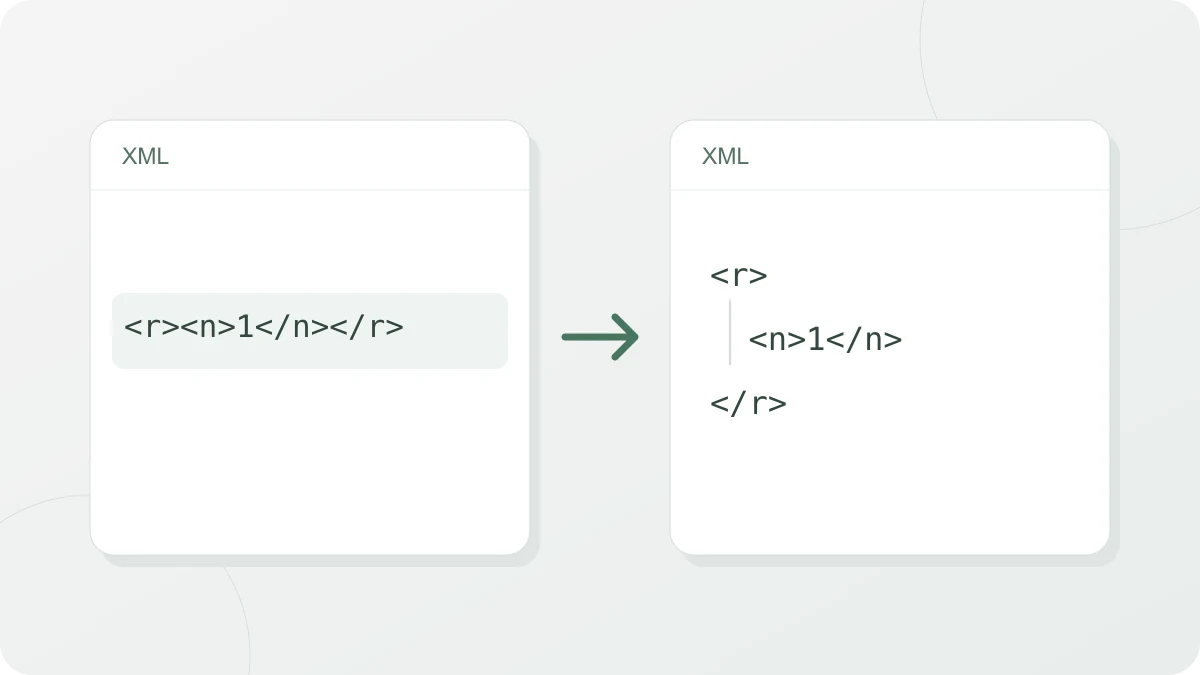
使い方
「方式」で「整形」を選ぶと、要素ごとに改行し、階層の深さに合わせてインデントします。インデントはその下のリストで「半角スペース2つ」「半角スペース4つ」「タブ」から選びます。「圧縮」を選ぶと、要素のあいだの改行とインデントを取り除いて1行につなげます。このときインデントのリストは表示されません。
1行につながった次の入力を半角スペース2つで整形すると、こうなります。
<order id="7"><item sku="A1" qty="2">Pen</item><item sku="B2" qty="1"/><note> keep spaces </note></order><order id="7">
<item sku="A1" qty="2">Pen</item>
<item sku="B2" qty="1"/>
<note> keep spaces </note>
</order>文字だけが入った要素(item、note)は1行に収め、中の文字は空白も含めてそのまま残します。結果の下の「行数」と「サイズ」は入力ではなく結果を測った値で、サイズはUTF-8のバイト数です。
そのまま残るものと、書き方が変わるもの
コメント(<!-- -->)、CDATAセクション(<![CDATA[ ]]>)、処理命令(<?name ?>)の中身は変えません。整形ではそれぞれを独立した行にインデントして置き、圧縮では前後の改行だけを取り除きます。先頭のXML宣言(<?xml version="1.0"?>)と <!DOCTYPE ...> 宣言は、内側の記述も含めて入力の文字のまま写します。
要素と属性は、ブラウザが文書をいったん読み込んでから書き出し直します。そのため、意味は同じでも書き方がひとつにそろえられます。
| 入力 | 結果 |
|---|---|
<b></b> |
<b/> |
<c> </c>(空白だけの要素) |
そのまま |
x='1' |
x="1" |
' |
' |
é、A |
é、A |
&、<、> |
そのまま |
気をつけたいのは2行目です。空白だけが入った要素は、整形でも圧縮でも空要素にはせず、空白をそのまま残します。xml:space="preserve" が付いていなくても同じです。空白そのものが値になっている文書(たとえば区切り文字として半角スペース1つを入れた要素)でも、その値は変わりません。
DOCTYPEの中で自分で定義した実体も、展開されて出てきます。<!ENTITY co "ACME"> を定義して本文に &co; と書くと、結果の本文には ACME と書かれ、DOCTYPEの定義はそのまま残ります。
文字と要素が混ざった内容は、整形と圧縮で扱いが違います
<p>Hello <b>big</b> world <i>x</i></p> のように、ひとつの要素の中に文字と子要素が一緒に入っている場合の話です。XMLではこれを混合内容(mixed content)と呼びます。整形は、文字のかたまりも要素と同じように1行ずつに分け、前後の空白を切り落とします。
<p>
  Hello
  <b>big</b>
  world
  <i>x</i>
</p>読みやすくはなりますが、Hello と <b> のあいだにあった空白1つが、改行とインデントに置き換わっています。文章の本文のように空白がそのまま画面に現れるXML(XHTML、DocBookなど)では、整形結果を元のファイルの代わりに保存せず、読むためだけに使ってください。
圧縮は逆に、こうした要素には手を付けません。文字が混ざった要素の中では空白も改行も元のままにするので、上の入力は圧縮しても変わりませんし、複数行にまたがっていれば改行も残ります。圧縮が取り除くのは、要素だけが並んでいる場所のインデントです。
チェックするのは文法までです
このツールが確かめるのは、文書が「整形式(well-formed)」のXMLかどうかだけです。開始タグと終了タグが対応しているか、属性値が引用符で囲まれているか、いちばん外側の要素がひとつだけか、といったXMLそのものの文法です。DTDやXSDといったスキーマが決めた構造(どの要素がどの順で並ぶか、どの属性が必須か)に従っているかどうかは「妥当(valid)」な文書かどうかの問題で、このツールは確認しません。結果が出たというのは、文法が合っているという意味でしかありません。
文法エラーがあると、結果の代わりに「整形式(well-formed)のXMLではありません。1行20列付近を確認してください。」のような案内と、その行、^ の印が表示されます。次の表はChromeで確かめた例です。
| 入力 | 表示される位置 | 原因 |
|---|---|---|
<a><b>1</b><c>2</b></a> |
1行20列 | <c> を </b> で閉じている |
<a>1</a><b>2</b> |
1行9列 | いちばん外側の要素が2つある |
<a b="1" b="2"/> |
1行15列 | 同じ属性が2回ある |
<x:a><x:b/></x:a> |
1行5列 | 接頭辞 x の名前空間宣言(xmlns:x)がない |
半角スペース2つのあとの <?xml version="1.0"?> |
1行8列 | XML宣言の前に別の文字がある |
最後のケースは、ファイルの中身をコピーしたときに先頭へ空行や空白が紛れ込むと起こります。宣言は文書の1文字目から始まっていなければなりません。
外部実体のある文書
DOCTYPEが外部ファイルを指す実体を定義していると、その実体を参照している箇所が結果では空になることがあります。
Chromeで <!DOCTYPE a [<!ENTITY e SYSTEM "http://example.invalid/e.txt">]><a>&e;</a> を整形すると、DOCTYPEはそのまま残り、本文は <a/> になります。外部実体を参照していた箇所がエラーもなく空になるので、こうした文書の整形結果を元のファイルの代わりに保存すると、参照が失われます。DOCTYPEに外部実体の宣言があるときは、結果の下にこの点を知らせる警告が出ます。