
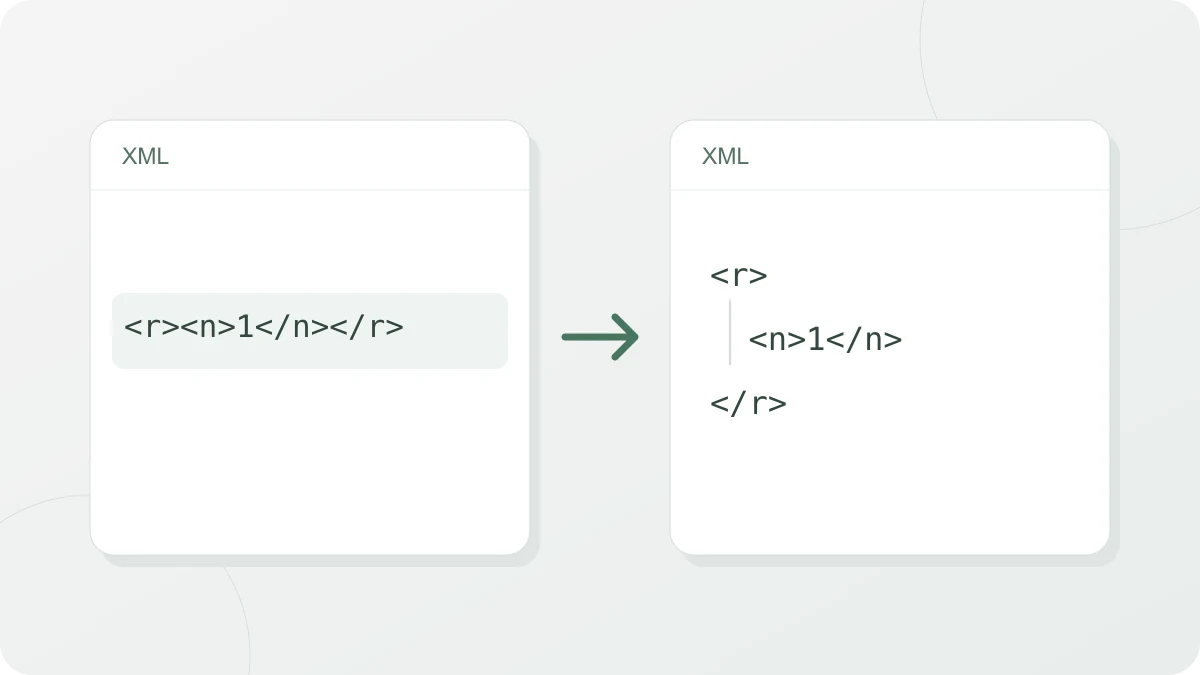
Formatieren oder minimieren
Wählst du unter „Modus“ die Einstellung „Formatieren“, bekommt jedes Element eine eigene Zeile und wird seiner Tiefe entsprechend eingerückt. Die Einrückung legst du in der Auswahlliste darunter fest: „2 Leerzeichen“, „4 Leerzeichen“ oder „Tabulator“. „Minimieren“ entfernt Zeilenumbrüche und Einrückung zwischen den Elementen und hängt alles zu einer Zeile zusammen. Die Auswahlliste für die Einrückung verschwindet dann.
Aus dieser einzeiligen Eingabe wird beim Formatieren mit 2 Leerzeichen Folgendes:
<order id="7"><item sku="A1" qty="2">Pen</item><item sku="B2" qty="1"/><note> keep spaces </note></order><order id="7">
<item sku="A1" qty="2">Pen</item>
<item sku="B2" qty="1"/>
<note> keep spaces </note>
</order>Elemente, die nur Text enthalten (item, note), bleiben in einer Zeile, und ihr Text bleibt samt Leerzeichen erhalten. „Zeilen“ und „Größe“ unter dem Ergebnis beziehen sich auf das Ergebnis, nicht auf die Eingabe. Die Größe ist die Zahl der UTF-8-Bytes.
Was unverändert bleibt und was anders geschrieben wird
Kommentare (<!-- -->), CDATA-Abschnitte (<![CDATA[ ]]>) und Verarbeitungsanweisungen (<?name ?>) behalten ihren Inhalt. Beim Formatieren bekommt jedes davon eine eigene, eingerückte Zeile, beim Minimieren fallen nur die Zeilenumbrüche davor und danach weg. Die XML-Deklaration am Anfang (<?xml version="1.0"?>) und die <!DOCTYPE ...>-Deklaration werden samt Inhalt Zeichen für Zeichen aus dem Original übernommen.
Elemente und Attribute dagegen liest der Browser ein und schreibt sie neu. Die Bedeutung bleibt, aber von mehreren möglichen Schreibweisen bleibt nur eine übrig.
| Eingabe | Ergebnis |
|---|---|
<b></b> |
<b/> |
<c> </c> (Element, das nur Leerzeichen enthält) |
unverändert |
x='1' |
x="1" |
' |
' |
é, A |
é, A |
&, <, > |
unverändert |
Achte auf die zweite Zeile. Ein Element, das nur Leerzeichen enthält, wird weder beim Formatieren noch beim Minimieren zu einem leeren Element, die Leerzeichen bleiben stehen. Das gilt auch ohne xml:space="preserve". In Dokumenten, in denen das Leerzeichen selbst der Wert ist (zum Beispiel ein Element, das ein einzelnes Leerzeichen als Trennzeichen enthält), ändert sich dieser Wert deshalb nicht.
Auch Entitäten, die im DOCTYPE selbst definiert sind, werden aufgelöst. Definierst du <!ENTITY co "ACME"> und schreibst im Inhalt &co;, steht im Ergebnis dort ACME. Die Definition im DOCTYPE bleibt stehen.
Text und Elemente gemischt: Formatieren und Minimieren gehen verschieden damit um
Gemeint sind Fälle wie <p>Hello <b>big</b> world <i>x</i></p>, in denen ein Element sowohl Text als auch Kindelemente enthält (in XML heißt das gemischter Inhalt, mixed content). Beim Formatieren bekommt auch jedes Textstück seine eigene Zeile, so wie ein Element, und die Leerzeichen an seinen Rändern werden abgeschnitten.
<p>
  Hello
  <b>big</b>
  world
  <i>x</i>
</p>
Das liest sich gut. Aus dem einen Leerzeichen zwischen Hello und <b> sind aber ein Zeilenumbruch und eine Einrückung geworden. Bei XML, dessen Leerzeichen später genau so auf dem Bildschirm erscheinen (Fließtext in XHTML, DocBook und Ähnlichem), solltest du das formatierte Ergebnis deshalb nur zum Lesen verwenden und nicht anstelle des Originals speichern.
Das Minimieren macht es umgekehrt und lässt solche Elemente in Ruhe. Innerhalb eines Elements mit gemischtem Inhalt bleiben Leerzeichen und Zeilenumbrüche, wie sie waren. Die Eingabe oben kommt also unverändert heraus, und erstreckte sie sich über mehrere Zeilen, blieben auch die Zeilenumbrüche erhalten. Entfernt wird nur die Einrückung an Stellen, an denen ausschließlich Elemente stehen.
Geprüft wird nur die Syntax
Das Tool stellt lediglich fest, ob ein Dokument wohlgeformt (well-formed) ist. Das betrifft die Syntax von XML selbst: Passt zu jedem öffnenden Tag ein schließendes, stehen die Attributwerte in Anführungszeichen, gibt es genau ein äußerstes Element? Ob das Dokument außerdem die Struktur einhält, die ein Schema wie DTD oder XSD vorgibt (welche Elemente in welcher Reihenfolge stehen müssen, welche Attribute Pflicht sind), ist die Frage nach einem gültigen (valid) Dokument. Die beantwortet das Tool nicht. Ein Ergebnis bedeutet nur: Die Syntax stimmt.
Bei einem Syntaxfehler erscheint statt des Ergebnisses eine Meldung wie „Das ist kein wohlgeformtes XML. Prüfe die Stelle bei Zeile 1, Spalte 20.“, dazu die betroffene Zeile und eine ^-Markierung. Die folgenden Beispiele wurden in Chrome überprüft.
| Eingabe | Angezeigte Position | Ursache |
|---|---|---|
<a><b>1</b><c>2</b></a> |
Zeile 1, Spalte 20 | <c> mit </b> geschlossen |
<a>1</a><b>2</b> |
Zeile 1, Spalte 9 | zwei äußerste Elemente |
<a b="1" b="2"/> |
Zeile 1, Spalte 15 | dasselbe Attribut zweimal |
<x:a><x:b/></x:a> |
Zeile 1, Spalte 5 | für das Präfix x fehlt die Namensraumdeklaration (xmlns:x) |
<?xml version="1.0"?> nach zwei Leerzeichen |
Zeile 1, Spalte 8 | vor der XML-Deklaration stehen andere Zeichen |
Der letzte Fall entsteht, wenn beim Kopieren eines Dateiinhalts eine Leerzeile oder Leerzeichen am Anfang mitkommen. Die Deklaration muss mit dem allerersten Zeichen des Dokuments beginnen.
Dokumente mit externen Entitäten
Definiert der DOCTYPE eine Entität, die auf eine externe Datei verweist, können die Stellen, die auf diese Entität verweisen, im Ergebnis leer sein.
Formatierst du in Chrome <!DOCTYPE a [<!ENTITY e SYSTEM "http://example.invalid/e.txt">]><a>&e;</a>, bleibt der DOCTYPE stehen und aus dem Inhalt wird <a/>. Die Stelle, an der die externe Entität referenziert war, ist ohne Fehlermeldung leer. Speicherst du bei einem solchen Dokument das formatierte Ergebnis anstelle des Originals, ist die Referenz verloren. Deklariert der DOCTYPE eine externe Entität, weist eine Warnung unter dem Ergebnis darauf hin.