
사용 방법
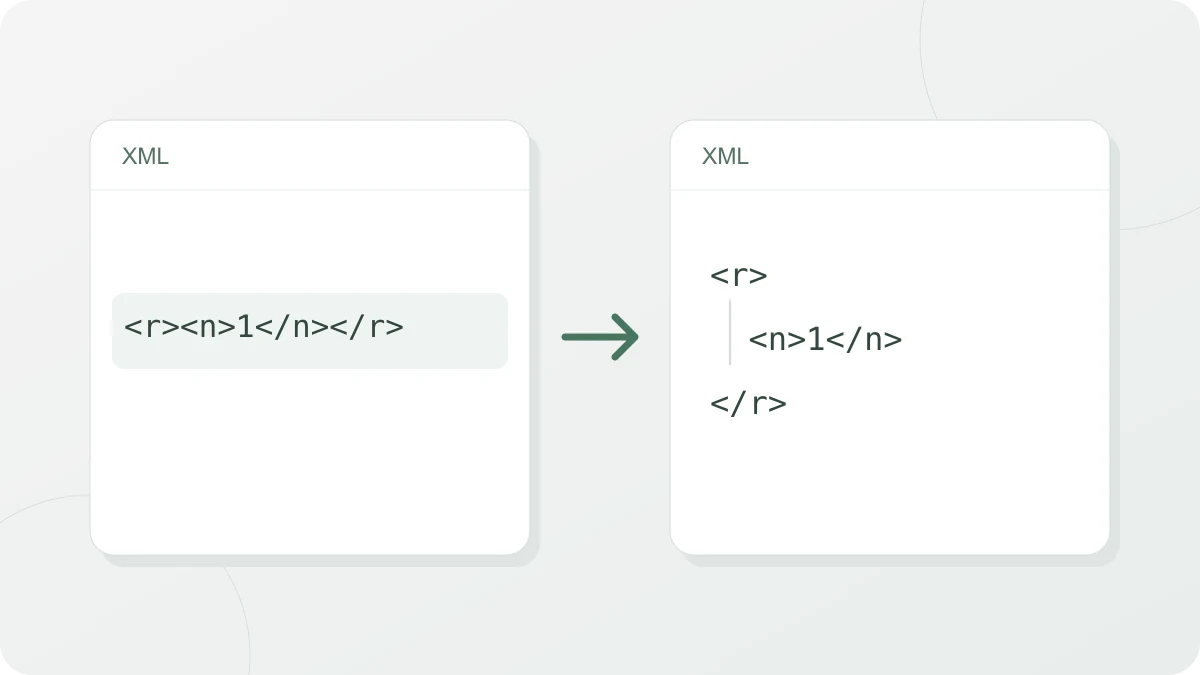
“방식”에서 “포맷”을 고르면 요소마다 줄을 나누고 깊이만큼 들여씁니다. 들여쓰기는 그 아래 목록에서 “공백 2칸”, “공백 4칸”, “탭” 중에 고릅니다. “압축”을 고르면 요소 사이의 줄바꿈과 들여쓰기를 없애 한 줄로 붙이고, 들여쓰기 목록은 사라집니다.
한 줄로 붙어 있는 다음 입력을 공백 2칸으로 포맷하면 이렇게 나옵니다.
<order id="7"><item sku="A1" qty="2">Pen</item><item sku="B2" qty="1"/><note> keep spaces </note></order><order id="7">
<item sku="A1" qty="2">Pen</item>
<item sku="B2" qty="1"/>
<note> keep spaces </note>
</order>글자만 들어 있는 요소(item, note)는 한 줄에 두고 안의 글자를 공백까지 그대로 남깁니다. 결과 아래의 “줄 수”와 “크기”는 입력이 아니라 결과를 잰 값이고, 크기는 UTF-8 바이트 수입니다.
그대로 남는 것과 표기가 바뀌는 것
주석(<!-- -->), CDATA 구간(<![CDATA[ ]]>), 처리 지시문(<?name ?>)은 내용을 바꾸지 않습니다. 포맷에서는 각각 자기 줄에 들여써서 놓고, 압축에서는 앞뒤 줄바꿈만 없앱니다. 맨 앞의 XML 선언(<?xml version="1.0"?>)과 <!DOCTYPE ...> 선언은 안쪽 내용까지 원문 글자 그대로 옮깁니다.
요소와 속성은 브라우저가 문서를 읽어 들인 뒤 다시 적기 때문에, 뜻은 같아도 표기가 한 가지로 통일됩니다.
| 입력 | 결과 |
|---|---|
<b></b> |
<b/> |
<c> </c> (공백만 든 요소) |
그대로 |
x='1' |
x="1" |
' |
' |
é, A |
é, A |
&, <, > |
그대로 |
눈여겨볼 것은 둘째 줄입니다. 공백만 들어 있는 요소는 포맷과 압축 모두에서 빈 요소로 줄이지 않고 공백을 그대로 둡니다. xml:space="preserve"가 붙어 있지 않아도 마찬가지입니다. 공백 자체가 값인 문서(예: 구분자로 공백 한 칸을 담은 요소)도 그 값이 바뀌지 않습니다.
DOCTYPE 안에서 직접 정의한 엔터티도 풀려서 나옵니다. <!ENTITY co "ACME">를 정의하고 본문에 &co;를 쓰면 결과 본문에는 ACME가 적히고, DOCTYPE의 정의는 그대로 남습니다.
글자와 요소가 섞인 내용은 포맷과 압축이 다르게 다룹니다
<p>Hello <b>big</b> world <i>x</i></p>처럼 한 요소 안에 글자와 자식 요소가 함께 있는 경우(혼합 콘텐츠)입니다. 포맷은 글자 조각도 요소처럼 한 줄씩 나누고 앞뒤 공백을 잘라 냅니다.
<p>
  Hello
  <b>big</b>
  world
  <i>x</i>
</p>
읽기에는 좋지만 Hello와 <b> 사이에 있던 공백 한 칸이 줄바꿈과 들여쓰기로 바뀌었습니다. 문서 본문처럼 공백이 화면에 그대로 나타나는 XML(XHTML, DocBook 등)이라면 포맷 결과를 원본 대신 저장하지 말고 읽는 용도로만 쓰세요.
압축은 반대로 이런 요소를 건드리지 않습니다. 글자가 섞인 요소 안에서는 공백과 줄바꿈을 원래대로 두기 때문에, 위 입력은 압축해도 그대로이고 여러 줄에 걸쳐 있었다면 줄바꿈도 남습니다. 압축이 없애는 것은 요소만 들어 있는 자리의 들여쓰기입니다.
검사하는 것은 문법까지입니다
이 도구는 문서가 “잘 만들어진(well-formed)” XML인지만 확인합니다. 여는 태그와 닫는 태그의 짝이 맞는지, 속성값이 따옴표로 감싸여 있는지, 가장 바깥 요소가 하나뿐인지 같은 XML 자체의 문법입니다. DTD나 XSD 같은 스키마가 정한 구조(어떤 요소가 어떤 순서로 와야 하는지, 어떤 속성이 필수인지)를 따르는지는 “유효한(valid)” 문서인지의 문제이고, 이 도구는 확인하지 않습니다. 결과가 나왔다는 것은 문법이 맞다는 뜻일 뿐입니다.
문법 오류가 있으면 결과 대신 “잘 만들어진(well-formed) XML이 아닙니다. 1행 20열 부근을 확인하세요.” 같은 안내와 그 줄, ^ 표시가 나옵니다. 아래는 Chrome에서 확인한 예입니다.
| 입력 | 표시되는 위치 | 원인 |
|---|---|---|
<a><b>1</b><c>2</b></a> |
1행 20열 | <c>를 </b>로 닫음 |
<a>1</a><b>2</b> |
1행 9열 | 가장 바깥 요소가 둘 |
<a b="1" b="2"/> |
1행 15열 | 같은 속성이 두 번 |
<x:a><x:b/></x:a> |
1행 5열 | 접두사 x의 네임스페이스 선언(xmlns:x)이 없음 |
공백 두 칸 뒤의 <?xml version="1.0"?> |
1행 8열 | XML 선언 앞에 다른 글자가 있음 |
마지막 경우는 파일 내용을 복사하다가 맨 앞에 빈 줄이나 공백이 딸려 올 때 생깁니다. 선언은 문서의 첫 글자부터 시작해야 합니다.
외부 엔터티가 있는 문서
DOCTYPE이 외부 파일을 가리키는 엔터티를 정의하고 있으면, 그 엔터티를 참조한 자리가 결과에서 비어 나올 수 있습니다.
Chrome에서 <!DOCTYPE a [<!ENTITY e SYSTEM "http://example.invalid/e.txt">]><a>&e;</a>를 포맷하면 DOCTYPE은 그대로 남고 본문은 <a/>가 됩니다. 외부 엔터티를 참조하던 자리가 오류 없이 비어 버리므로, 이런 문서의 포맷 결과를 원본 대신 저장하면 참조가 사라집니다. DOCTYPE에 외부 엔터티 선언이 있으면 결과 아래에 이 점을 알리는 경고가 나옵니다.