
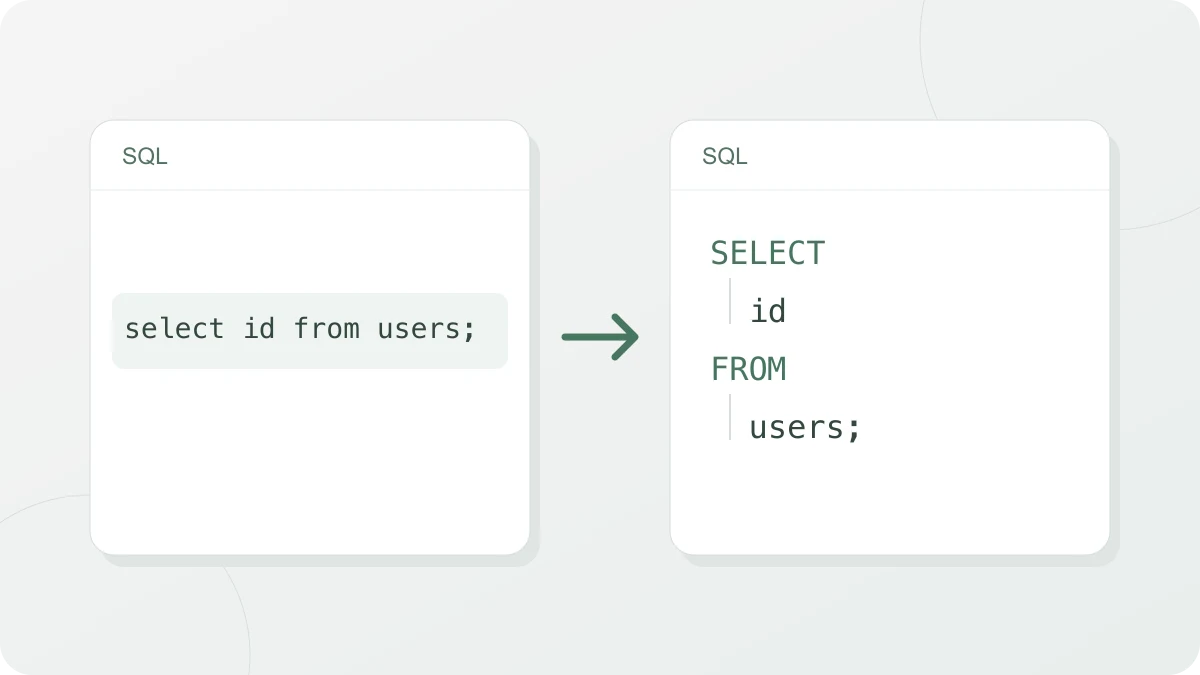
사용 방법
먼저 “방언”에서 쿼리를 실행할 데이터베이스를 고릅니다. 고를 수 있는 것은 “표준 SQL”, “MySQL”, “PostgreSQL”, “SQLite”, “T-SQL (SQL Server)”, “BigQuery”입니다. 그다음 “입력”에 쿼리를 넣고 아래 세 가지를 정합니다.
- 키워드 대소문자: “대문자 (SELECT)”, “소문자 (select)”, “입력 그대로” 중 하나입니다.
- 들여쓰기: “공백 2칸”, “공백 4칸”, “탭” 중 하나입니다.
- 쿼리 사이 빈 줄: 세미콜론(;)으로 나뉜 쿼리 사이에 넣을 빈 줄 수입니다. 0부터 5까지 넣을 수 있고 처음 값은 1입니다.
표준 SQL, 대문자, 공백 2칸으로 다음 한 줄을 정렬한 결과입니다.
select u.id, count(o.id) as orders from users u left join orders o on o.user_id = u.id where u.created_at >= '2026-01-01' group by u.id having count(o.id) > 3 order by orders descSELECT
u.id,
count(o.id) AS orders
FROM
users u
LEFT JOIN orders o ON o.user_id = u.id
WHERE
u.created_at >= '2026-01-01'
GROUP BY
u.id
HAVING
count(o.id) > 3
ORDER BY
orders DESC“결과”에서는 키워드가 굵게, 문자열과 숫자가 색으로, 주석이 기울임꼴로 구분됩니다. 이 구분은 낱말 모양만 보고 칠하는 것이어서, default나 index처럼 예약어와 이름이 같은 열 이름은 따옴표로 감싸지 않으면 키워드처럼 굵게 보입니다. 결과가 20만 자를 넘으면 “결과가 커서 색 구분 없이 표시합니다”라고 나오고 글자만 보여 줍니다. 결과 아래의 “줄 수”와 “크기”는 정렬된 결과를 잰 값입니다.
여러 쿼리를 한꺼번에 넣으면 세미콜론을 기준으로 각각 정렬합니다. 마지막 쿼리에 세미콜론이 없으면 결과에도 붙이지 않습니다.
키워드 대소문자가 바꾸는 범위
“키워드 대소문자”는 select, from, as, join 같은 예약어에만 적용됩니다. 함수 이름과 자료형, 테이블과 열 이름, 문자열 안의 글자는 입력한 그대로 둡니다.
- “대문자 (SELECT)“로
select count(*), cast(x as int) from t를 정렬하면SELECT,AS,FROM만 대문자가 되고count(*)와int는 소문자로 남습니다. - “소문자 (select)“로
SELECT Now() FROM t를 정렬하면select와from은 소문자가 되고Now()는 그대로입니다. where name = 'select from'의 따옴표 안은 어떤 설정에서도 바뀌지 않습니다.
COUNT나 INT까지 대문자로 맞추는 팀 규칙이 있다면 그 부분은 직접 고쳐야 합니다.
방언을 잘못 고르면 생기는 일
따옴표와 자리표시자 표기는 데이터베이스마다 다릅니다. 맞지 않는 방언을 고르면 실행에는 문제가 없는 쿼리도 해석하지 못해 오류가 됩니다. 아래는 같은 입력을 여섯 방언으로 각각 돌려 본 결과입니다.
| 입력 | 오류가 나는 방언 | 정렬되는 방언 |
|---|---|---|
select [a] from [t] |
표준 SQL, MySQL (1행 8열) | PostgreSQL, SQLite, T-SQL, BigQuery |
select `a` from `t` |
PostgreSQL, T-SQL (1행 8열) | 표준 SQL, MySQL, SQLite, BigQuery |
select a::int from t |
표준 SQL, MySQL, SQLite, BigQuery (1행 9열) | PostgreSQL, T-SQL |
select * from t where a = $1 |
표준 SQL, SQLite, T-SQL, BigQuery (1행 27열) | MySQL, PostgreSQL |
오류가 나지 않아도 결과가 미묘하게 달라질 수 있습니다. select top 5 a from t를 “T-SQL (SQL Server)“로 정렬하면 TOP이 대문자가 되지만, 다른 다섯 방언에서는 top이 키워드로 인식되지 않아 소문자로 남습니다. 반대로 limit 5는 T-SQL에서만 소문자로 남습니다. 오류가 사라질 때까지 방언을 바꿔 보기보다, 실제로 쓰는 데이터베이스를 고르는 편이 안전합니다.
오류가 없다고 올바른 SQL은 아닙니다
이 도구는 쿼리를 실행하지도, 문법을 끝까지 검사하지도 않습니다. 낱말을 나누고 절의 경계를 찾아 줄을 맞출 뿐이라, 틀린 쿼리도 대부분 그대로 통과합니다.
selct * form users(오타)는 오류 없이 한 줄 그대로 나옵니다. 절로 나뉘지 않았다는 것이 유일한 단서입니다.select * from users where(조건이 빠짐)는WHERE에서 끝나는 모양으로 정렬됩니다.
오류로 잡히는 것은 주로 짝이 맞지 않는 괄호나 따옴표, 그리고 고른 방언에 없는 기호입니다. 이때는 “SQL을 해석할 수 없습니다. 1행 24열 부근을 확인하세요.” 같은 안내와 그 줄, ^ 표시가 나옵니다.
| 입력 (표준 SQL) | 표시되는 위치 | 원인 |
|---|---|---|
select * from (select 1 |
1행 24열 (입력의 끝) | 괄호를 닫지 않음 |
select * from users) |
1행 20열 | 여는 괄호 없이 닫음 |
select 'abc |
1행 8열 | 따옴표를 닫지 않음 |
닫지 않은 괄호는 입력의 끝을 가리키므로, 표시된 자리가 아니라 그 앞에서 짝이 없는 여는 괄호를 찾아야 합니다.
정렬 엔진은 처음 입력할 때 내려받습니다
정렬은 sql-formatter라는 오픈소스 라이브러리가 맡습니다. 용량이 커서 페이지를 열 때가 아니라 쿼리를 처음 입력하는 순간에 내려받고, 그동안 결과 칸에 “정렬하는 중…“이 보입니다. 내려받는 것은 엔진 코드뿐이고 쿼리는 그 요청에 실리지 않습니다. 페이지를 연 뒤 인터넷이 끊긴 상태에서 처음 입력하면 “정렬 엔진을 불러오지 못했습니다. 인터넷 연결을 확인하고 페이지를 새로 고치세요.“가 나옵니다.
한 줄로 붙이는 압축 기능은 없습니다. 이 라이브러리가 줄을 나눠 정렬하는 기능만 제공하고, 공백을 직접 지우는 방식은 문자열이나 주석 안의 공백까지 건드릴 위험이 있어 넣지 않았습니다. 줄 수를 줄이고 싶다면 “쿼리 사이 빈 줄”을 0으로 두는 정도가 가능한 전부입니다.