
使い方
まず「方言」で、クエリを実行するデータベースを選びます。選べるのは「標準SQL」「MySQL」「PostgreSQL」「SQLite」「T-SQL(SQL Server)」「BigQuery」です。続いて「入力」にクエリを入れ、次の3つを決めます。
- キーワードの大文字・小文字:「大文字(SELECT)」「小文字(select)」「入力のまま」のいずれかです。
- インデント:「半角スペース2つ」「半角スペース4つ」「タブ」のいずれかです。
- クエリ間の空行:セミコロン(;)で区切られたクエリのあいだに入れる空行の数です。0から5まで指定でき、初期値は1です。
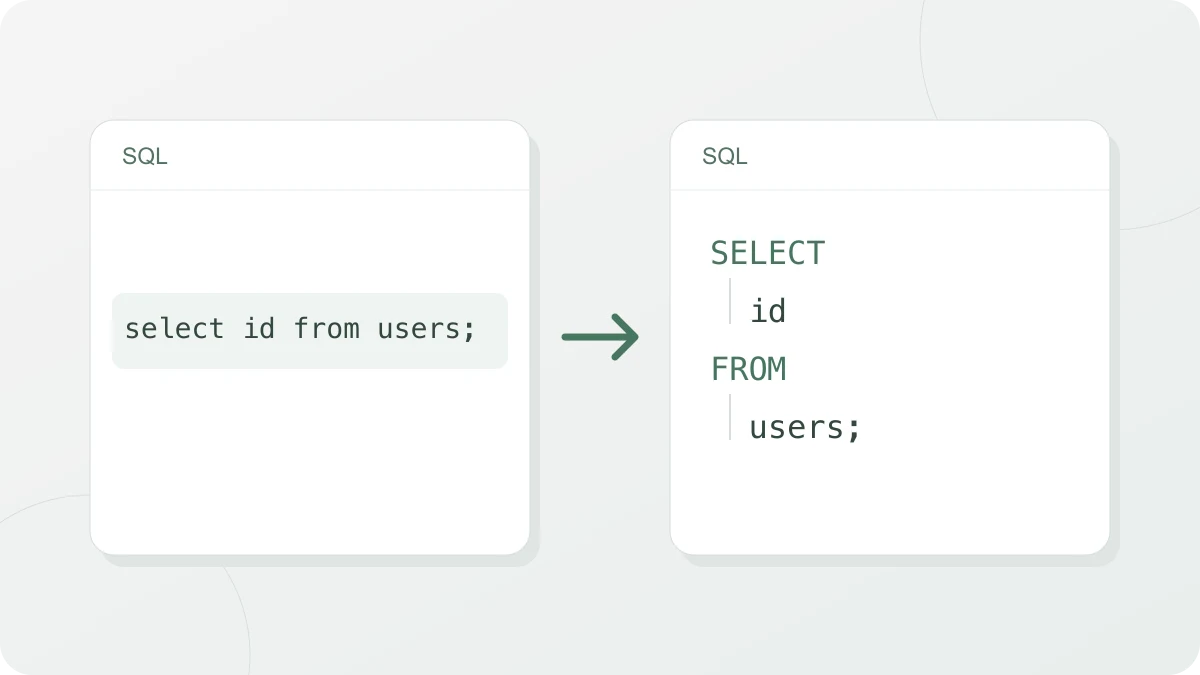
標準SQL、大文字、半角スペース2つで次の1行を整形した結果です。
select u.id, count(o.id) as orders from users u left join orders o on o.user_id = u.id where u.created_at >= '2026-01-01' group by u.id having count(o.id) > 3 order by orders descSELECT
u.id,
count(o.id) AS orders
FROM
users u
LEFT JOIN orders o ON o.user_id = u.id
WHERE
u.created_at >= '2026-01-01'
GROUP BY
u.id
HAVING
count(o.id) > 3
ORDER BY
orders DESC「結果」では、キーワードが太字、文字列と数値が色、コメントが斜体で区別されます。この色分けは単語の見た目だけで判断しているので、default や index のように予約語と同じ名前の列は、引用符で囲まないかぎりキーワードと同じ太字になります。結果が20万文字を超えると「結果が大きいため、色分けせずに表示します」と表示され、文字だけになります。結果の下の「行数」と「サイズ」は、整形後の結果を測った値です。
複数のクエリをまとめて入れると、セミコロンを区切りにしてそれぞれを整形します。最後のクエリにセミコロンがなければ、結果にも付けません。
「キーワードの大文字・小文字」が変える範囲
「キーワードの大文字・小文字」が効くのは、select、from、as、join といった予約語だけです。関数名とデータ型、テーブル名と列名、文字列の中の文字は、入力したままにします。
- 「大文字(SELECT)」で
select count(*), cast(x as int) from tを整形すると、大文字になるのはSELECT、AS、FROMだけで、count(*)とintは小文字のまま残ります。 - 「小文字(select)」で
SELECT Now() FROM tを整形すると、selectとfromは小文字になり、Now()はそのままです。 where name = 'select from'の引用符の中は、どの設定でも変わりません。
COUNT や INT まで大文字にそろえるチームのルールがあるなら、その部分は自分で直す必要があります。
方言を選び間違えると起こること
引用符やプレースホルダーの書き方は、データベースごとに違います。合わない方言を選ぶと、実行するうえでは問題のないクエリでも解析できずにエラーになります。次の表は、同じ入力を6つの方言それぞれで試した結果です。
| 入力 | エラーになる方言 | 整形できる方言 |
|---|---|---|
select [a] from [t] |
標準SQL、MySQL(1行8列) | PostgreSQL、SQLite、T-SQL、BigQuery |
select `a` from `t` |
PostgreSQL、T-SQL(1行8列) | 標準SQL、MySQL、SQLite、BigQuery |
select a::int from t |
標準SQL、MySQL、SQLite、BigQuery(1行9列) | PostgreSQL、T-SQL |
select * from t where a = $1 |
標準SQL、SQLite、T-SQL、BigQuery(1行27列) | MySQL、PostgreSQL |
エラーにならなくても、結果が微妙に変わることがあります。select top 5 a from t を「T-SQL(SQL Server)」で整形すると TOP は大文字になりますが、ほかの5つの方言では top がキーワードとして認識されず、小文字のまま残ります。逆に limit 5 は、T-SQLでだけ小文字のままです。エラーが消えるまで方言を切り替えて試すより、実際に使っているデータベースを選ぶほうが安全です。
エラーが出なくても、正しいSQLとは限りません
このツールはクエリを実行しませんし、文法を最後まで検査することもしません。単語に分け、句の境目を見つけて行をそろえているだけなので、間違ったクエリも大半はそのまま通ります。
selct * form users(打ち間違い)は、エラーにならず1行のまま出てきます。句ごとに分かれなかったことが唯一の手がかりです。select * from users where(条件が抜けている)は、WHEREで終わる形に整形されます。
エラーとして捕まるのは、おもに対応の取れていない括弧や引用符、そして選んだ方言にない記号です。その場合は「このSQLを解析できません。1行24列付近を確認してください。」のような案内と、その行、^ の印が表示されます。
| 入力(標準SQL) | 表示される位置 | 原因 |
|---|---|---|
select * from (select 1 |
1行24列(入力の末尾) | 括弧を閉じていない |
select * from users) |
1行20列 | 開き括弧がないのに閉じている |
select 'abc |
1行8列 | 引用符を閉じていない |
閉じていない括弧は入力の末尾を指します。表示された位置ではなく、それより前で相手のいない開き括弧を探してください。
整形エンジンは最初の入力時に読み込みます
整形を受け持つのは、sql-formatterというオープンソースのライブラリです。サイズが大きいので、ページを開いたときではなく、クエリを最初に入力した時点でダウンロードします。そのあいだ、結果欄には「整形しています…」と表示されます。ダウンロードするのはエンジンのコードだけで、クエリがそのリクエストに載ることはありません。ページを開いたあとインターネットが切れた状態で最初の入力をすると、「整形エンジンを読み込めませんでした。インターネット接続を確認してページを再読み込みしてください。」と表示されます。
1行にまとめる圧縮機能はありません。このライブラリが提供しているのは改行して整える機能だけです。空白を単純に削る方法は、文字列やコメントの中の空白まで壊すおそれがあるため入れていません。行数を減らしたい場合にできるのは、「クエリ間の空行」を0にすることくらいです。