
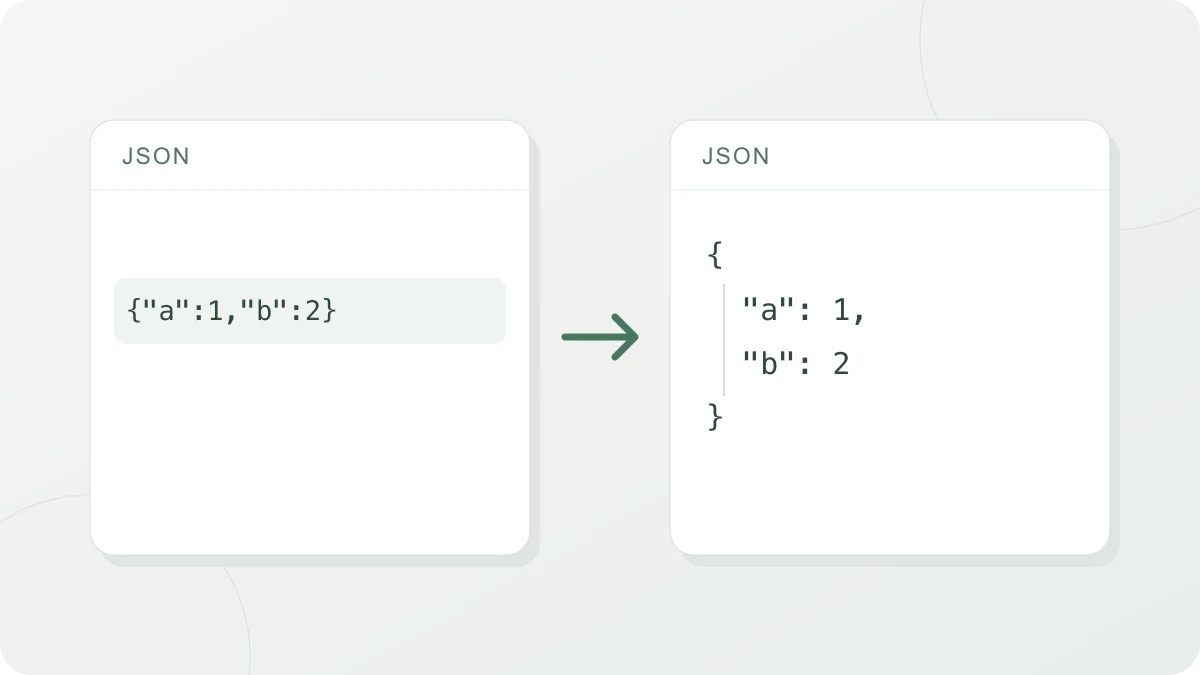
使い方
「方式」で次の3つから選びます。
- 整形:改行とインデントを入れて、構造が見えるようにします。インデントはリストから「半角スペース2つ」「半角スペース4つ」「タブ」のどれかを選びます。
- 圧縮:値のあいだの空白と改行をすべて取り除き、1行にまとめます。この方式ではインデントのリストは表示されません。
- 検証:出力は整形とまったく同じで、文法が正しければ「正しいJSONです。」という表示がひとつ加わります。整形や圧縮で結果が出ているなら、その入力はすでに文法チェックを通っています。
チェックボックスは3つの方式すべてに効きます。
- 「キーを並べ替え」:入れ子になったオブジェクトも含め、すべてのオブジェクトのキーを文字コード順に並べ替えます。大文字は小文字より前、英字は
é、가、日のようなASCII以外の文字より前に来ます。{"z":1,"a":{"c":2,"b":3}}は{"a":{"b":3,"c":2},"z":1}になります。配列の中の順序には手を付けません。 - 「ASCII以外の文字をエスケープ (\uXXXX)」:アクセント付きの文字や絵文字のようなASCII以外の文字を
\uXXXXの形に置き換えます。"é😀"は"\u00e9\ud83d\ude00"になります。絵文字はコード2つに分けて書かれます。 - 「コメント・trailing commaを許可 (JSON5/JSONC)」:このページの最後のセクションで説明します。
結果の下には数値が3つ出ます。「キー数」は内側のオブジェクトのキーまですべて数えた値で、「ネストの深さ」はいちばん外側の括弧を1と数えます。「サイズ」は入力ではなく結果のUTF-8バイト数です。{"order":{"id":1001,"items":[{"sku":"A1","qty":2}],"paid":true}} を半角スペース2つで整形すると、キー数6、ネストの深さ4、サイズ129Bです。同じ入力を圧縮に切り替えると、サイズだけが小さくなります。
値は同じでも書き方が変わるところ
このツールは、入力をブラウザのJSONパーサー(JSON.parse)で読み込んでから、あらためて文字列として書き出します。そのため変わるのは空白だけではありません。同じ意味を別の書き方で表していた部分は、ひとつの書き方にそろえられます。
| 入力 | 結果 |
|---|---|
1.0 |
1 |
0.10 |
0.1 |
1e2 |
100 |
1E-7 |
1e-7 |
-0 |
0 |
"\u00e9" |
"é" |
"a\/b" |
"a/b" |
数値の大きさや文字列の中身は変わりません。ただ、元のテキストと1文字ずつ突き合わせる用途(署名の検証、ハッシュの比較、行単位のdiff)では、この違いが表に出ます。-0 だけは符号が消えるので、負のゼロを区別するプログラムに渡すデータでは注意してください。
値そのものが変わるときに出る3つの警告
エラーにはならずに結果が出るものの、値が元と変わってしまう場合があります。このツールはそのうち3つの場合を、結果と一緒に警告として知らせます。警告が出ても結果はそのまま表示されます。
- 15桁を超える整数:JavaScriptの数値が整数を正確に持てるのは 2^53 - 1(9007199254740991)までです。
{"id":9007199254740993}を入れると結果は9007199254740992になり、末尾の桁が変わります。警告は実際に値が変わったかどうかではなく桁数(16桁以上の整数)で判断するので、1234567890123456のように値が変わらない16桁の整数にも出ます。小数点や指数の付いた数値と、文字列の中の数字は数えません。大きなIDを正確に残したいなら、データを作る側で文字列("id":"9007199254740993")として出力する必要があります。 - 表現できる範囲を超えた数値:
1e400のように大きすぎる数値は、結果ではnullになります。 - 同じオブジェクト内の重複キー:
{"a":1,"a":2}は{"a":2}になります。前の値は消え、最後の値だけが残ります。警告には、重複したキーの名前が5個まで表示されます。
エラー位置の読み方
文法に誤りがあると、結果の代わりに「正しいJSONではありません。3行21列付近を確認してください。」のような案内が出て、その行の前後と ^ の印が表示されます。
2 |   "name": "a",
3 |   "tags": ["x", "y",]
  |                     ^
4 | }
^ が指しているのは、それ以上読み進められなくなった最初の文字です。原因はその位置か、すぐ手前にあります。上の例で ^ は ] を指していますが、直すべきなのはその前のカンマです。知らせるのは最初に見つかったエラー1つだけなので、直したあとに次のエラーが出てくることがあります。
よく引っかかる入力は次のとおりです。
- 最後の要素のあとのカンマ:
[1, 2, 3,] - 一重引用符の文字列や、引用符のないキー:
{'a': 1}、{a: 1} //や/* */のコメント- 先頭に0が付いた数値:
01 NaNやundefinedのように、JSONにない値- 文字列の中にそのまま入った改行(
\nと書く必要があります)
このうちカンマとコメントの2つだけは下のオプションで通せます。残りは自分で直すしかありません。
「コメント・trailing commaを許可」オプションがすること
標準のJSON(RFC 8259、ECMA-404)は、コメントも、最後の要素のあとのカンマ(trailing comma、末尾カンマ)も認めていません。一方で、エディターの設定ファイルのように人が手で書き換えるファイルでは、これらを認める派生形式のJSONC(JSON with Comments)やJSON5がよく使われています。「コメント・trailing commaを許可 (JSON5/JSONC)」をオンにすると、解析の前に // コメント、/* */ コメント、閉じ括弧の直前のカンマを取り除きます。文字列の中にある // やカンマは消さないので、"http://x//y" のような値はそのまま残ります。
知っておきたい点が3つあります。
- 対応しているのはコメントとカンマだけです。JSON5が認めている一重引用符や引用符のないキーは、オプションをオンにしてもエラーになります。
- 結果は標準のJSONなので、コメントは残りません。コメントを残したままインデントだけ整える、という使い方はできません。
- オプションをオンにした状態でエラーが出ても、エラーの抜粋にはコメントを取り除く前の入力がそのまま表示されます。行番号と列番号も元の入力が基準なので、同じ行のエラー位置より前に
/* */コメントがあっても列番号はずれません。
受け取ったデータが標準のJSONかどうかを確かめたいときは、このオプションをオフにしておいてください。オンのままだと、コメントが混じった入力も通ってしまいます。