
사용 방법
이 페이지에는 도구가 둘 있습니다. 위쪽은 문자열을 인코딩하거나 디코딩하고, 아래쪽 “URL 구조 분석”은 완전한 URL 하나를 부분별로 나눠 보여 줍니다. 둘은 서로 영향을 주지 않습니다.
위쪽은 “방향”에서 “인코딩”이나 “디코딩”을 고른 뒤 두 가지를 정합니다.
- 인코딩 방식: “값 하나”는 쿼리 파라미터의 값처럼 URL에 끼워 넣을 조각에, “전체 URL”은 이미 주소 모양을 갖춘 문자열에 씁니다. 차이는 다음 항목에서 설명합니다.
- + 를 공백으로 (application/x-www-form-urlencoded): HTML 폼이 보내는 데이터를 다룰 때만 켭니다.
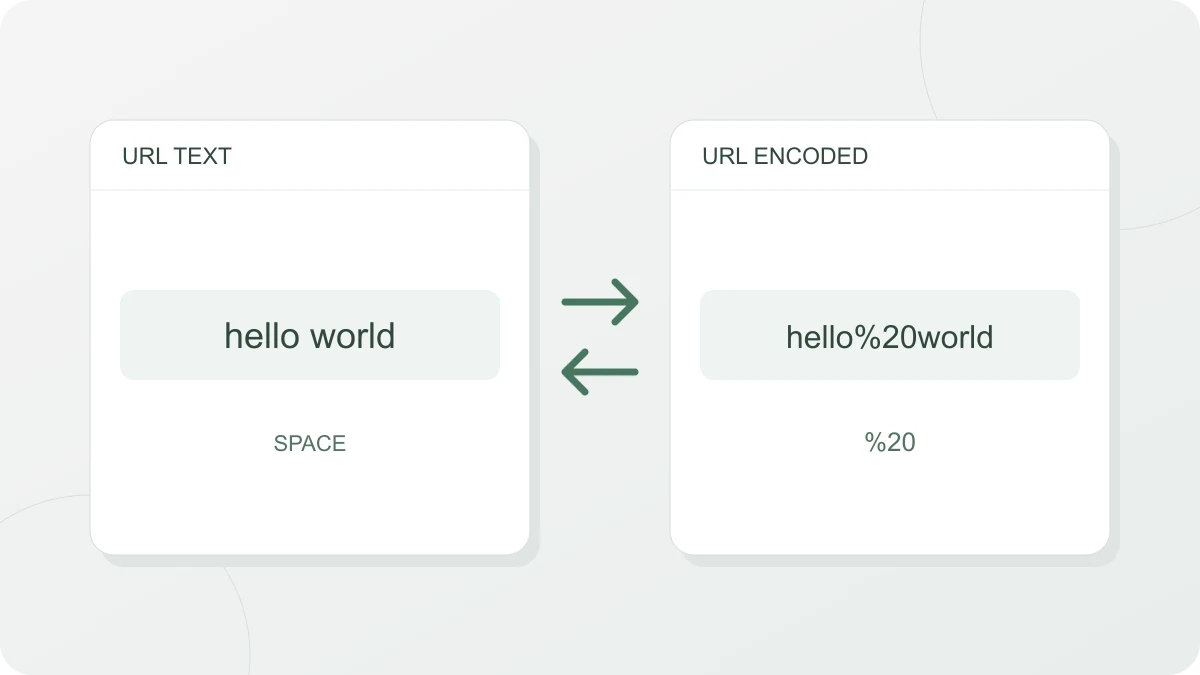
인코딩에서는 “원문”에 넣은 글이 “인코딩 결과”로, 디코딩에서는 “인코딩된 문자열”이 “디코딩 결과”로 나옵니다. €를 인코딩하면 %E2%82%AC입니다. 이 글자는 UTF-8로 3바이트여서 %XX 세 개가 됩니다. “결과를 디코딩 입력으로”, “결과를 인코딩 입력으로”는 방금 나온 결과를 반대 방향의 입력으로 옮깁니다.
“값 하나”와 “전체 URL”은 남겨 두는 글자가 다릅니다
두 방식 모두 URL에 그대로 쓸 수 없는 글자를 %와 16진수 두 자리로 바꿉니다(퍼센트 인코딩). 다른 점은 /, ?, &처럼 URL의 구조를 나누는 글자를 어떻게 다루느냐입니다. “값 하나”는 자바스크립트의 encodeURIComponent, “전체 URL”은 encodeURI와 같은 결과를 냅니다.
| 인코딩 방식 | 바꾸지 않고 남기는 글자 |
|---|---|
| 값 하나 | 영문자, 숫자, - _ . ! ~ * ' ( ) |
| 전체 URL | 위 글자 전부와 ; / ? : @ & = + $ , # |
같은 입력 https://example.com/café?q=crème brûlée&page=1#menü를 두 방식으로 인코딩하면 이렇게 갈립니다.
- 전체 URL:
https://example.com/caf%C3%A9?q=cr%C3%A8me%20br%C3%BBl%C3%A9e&page=1#men%C3%BC - 값 하나:
https%3A%2F%2Fexample.com%2Fcaf%C3%A9%3Fq%3Dcr%C3%A8me%20br%C3%BBl%C3%A9e%26page%3D1%23men%C3%BC
첫째는 주소로 바로 쓸 수 있고, 둘째는 주소로는 못 쓰지만 다른 URL의 파라미터 값(?redirect=...)으로 통째로 넣을 수 있습니다. 반대로 검색어 a/b&c를 쿼리 값으로 넣을 때 “전체 URL”을 쓰면 &가 그대로 남아 다음 파라미터의 시작으로 읽힙니다. 이때는 “값 하나”로 a%2Fb%26c를 만들어야 합니다.
디코딩에서도 같은 차이가 있습니다. “전체 URL”로 디코딩하면 구조를 나누는 글자의 인코딩은 풀지 않습니다. a%2Fb%3Fc%26d%23e%20f를 넣으면 “값 하나”는 a/b?c&d#e f를, “전체 URL”은 a%2Fb%3Fc%26d%23e f를 돌려줍니다. 디코딩했는데 %2F나 %26이 남아 있다면 인코딩 방식을 “값 하나”로 바꿔 보세요.
“값 하나”로도 ! ' ( ) *는 바뀌지 않는다는 점은 기억해 둘 만합니다. 이 글자까지 인코딩하기를 요구하는 서버에 보낼 값이라면 결과에서 직접 %21, %27, %28, %29, %2A로 바꿔야 합니다.
+ 를 공백으로
HTML <form>이 보내는 데이터(application/x-www-form-urlencoded)는 공백을 %20이 아니라 +로 적습니다. 이 형식을 만들거나 읽을 때 “+ 를 공백으로”를 켭니다.
| 방향 | 입력 | 옵션 끔 | 옵션 켬 |
|---|---|---|---|
| 인코딩 (값 하나) | a+b c |
a%2Bb%20c |
a%2Bb+c |
| 인코딩 (전체 URL) | a+b c |
a+b%20c |
a%2Bb+c |
| 디코딩 (값 하나) | a+b%2Bc |
a+b+c |
a b+c |
옵션을 켜면 원문에 있던 +는 공백과 헷갈리지 않도록 %2B가 됩니다. “전체 URL” 방식은 평소에는 +를 그대로 두지만 이 옵션을 켰을 때는 똑같이 %2B로 바꿉니다. 옵션을 끈 디코딩에서 +는 그냥 +입니다. 검색 결과 주소에서 복사한 q=crème+brûlée 같은 값을 디코딩했는데 +가 남아 있다면 이 옵션을 켜야 하는 경우입니다. URL 경로나 파일 이름에서는 +가 공백을 뜻하지 않으므로 꺼 두세요.
URL 구조 분석이 보여 주는 값
“전체 URL” 칸에 https://처럼 프로토콜로 시작하는 완전한 URL을 넣으면 “프로토콜”, “호스트”, “경로”가 나오고, 있을 때만 “쿼리 문자열”과 “해시”가 더해집니다. 그 아래 표에는 쿼리 파라미터가 “키”와 “값 (디코딩됨)“으로 한 줄씩 나옵니다. example.com/path처럼 프로토콜이 없으면 “프로토콜(https:// 등)을 포함한 완전한 URL이 아닙니다.“라고 나옵니다.
보여 주는 값은 입력한 글자 그대로가 아니라 브라우저가 URL을 해석해 정리한 값입니다. https://Example.COM:443/a/../b/café?q=hello%20world&tag=a&tag=b&x=1+2#top을 넣으면 다음과 같습니다.
| 항목 | 표시되는 값 | 입력과 달라진 점 |
|---|---|---|
| 프로토콜 | https |
|
| 호스트 | example.com |
소문자로 바뀌고, https의 기본 포트 443은 빠집니다 |
| 경로 | /b/caf%C3%A9 |
/a/..이 정리되고 é는 인코딩된 모습으로 나옵니다 |
| 쿼리 문자열 | ?q=hello%20world&tag=a&tag=b&x=1+2 |
입력 그대로 |
| 해시 | #top |
표에는 q = hello world, tag = a, tag = b, x = 1 2 네 줄이 나옵니다. 같은 키가 여러 번 나오면 줄도 여러 개입니다. x의 값에서 보듯 이 표는 위쪽의 “+ 를 공백으로” 체크박스와 상관없이 +를 항상 공백으로 읽습니다. 쿼리 문자열은 폼 데이터 형식으로 해석하는 것이 URL 표준의 규칙이기 때문입니다.
두 가지를 더 알아 두세요. ASCII가 아닌 글자가 들어간 도메인은 “호스트”에 퓨니코드로 나옵니다(https://café.example/ → xn--caf-dma.example). 그리고 http://user:pw@host:8080/p처럼 주소에 아이디와 비밀번호가 들어 있으면 그 부분은 어느 항목에도 표시되지 않고 “호스트”에는 host:8080만 나옵니다.
디코딩이 실패하는 입력
디코딩은 % 뒤에 16진수 두 자리가 오고, 그렇게 모인 바이트가 UTF-8 글자를 이룰 때만 성공합니다. 하나라도 어긋나면 결과 없이 “퍼센트(%) 인코딩이 올바르지 않습니다.“로 시작하는 안내가 나옵니다.
| 입력 | 실패하는 이유 |
|---|---|
100% |
% 뒤에 아무것도 없습니다. 퍼센트 기호 자체는 %25로 적어야 합니다 |
%zz |
zz는 16진수가 아닙니다 |
%E2%82 |
3바이트짜리 글자 €(%E2%82%AC)에서 마지막 바이트가 빠졌습니다. 긴 주소를 중간에서 잘라 복사했을 때 생깁니다 |
인코딩 쪽은 실패하지 않습니다. 반쪽만 남은 이모지처럼 그 자체로 글자가 되지 못하는 입력도 오류 대신 대체 문자(%EF%BF%BD)로 인코딩합니다.